Tornado-模板和数据库以及接口的调用顺序
这篇讲什么
- 先把一次请求在
RequestHandler里走过的顺序钉死(set_default_headers→initialize→prepare→ HTTP 方法 →on_finish,出错时中间还会再走一次set_default_headers和write_error),这是排查「我的代码到底什么时候跑的」的基础。 - 模板部分覆盖变量取值规则、
if/for/while、四种关转义的写法、继承与包含、static_url和自定义函数。 - 数据库部分给 Tornado 里接 SQLAlchemy 的可跑写法,并用实测数字说明「同步查询会把整个事件循环卡住」。
接口调用顺序
-
一个处理类里能被调到的方法,先认全:
initialize(**kwargs):接路由表里传下来的参数,每个请求新建实例时调用一次。prepare():预处理,任何 HTTP 方法都会先走它,适合放「统一鉴权、统一开 session」。- HTTP 方法:
get/post/head/delete/put/patch/options,由SUPPORTED_METHODS决定接哪些。 set_default_headers():进方法之前设默认响应头。write_error(status_code, **kwargs):渲染错误页。on_finish():响应发完后的收尾,做清理和日志;别在这里再写响应。
-
正常路径实测(每步
print,请求GET /):1
2
3
4
5
6set_default_headers
initialize
prepare
HTTP方法 get
on_finish
-> 200 -
方法里
send_error(500)之后,实测顺序变成:1
2
3
4
5
6
7
8set_default_headers
initialize
prepare
HTTP方法 get
set_default_headers # 又走了一次
write_error
on_finish
-> 500第二次
set_default_headers是因为错误页也是一次独立输出,Tornado 要重刷默认头。老笔记这个顺序表是准的。 -
完整示例(本机跑过):
views/index.py 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22class OrderHandler(RequestHandler):
def initialize(self):
print("initialize")
def prepare(self):
print("prepare")
def set_default_headers(self):
print("set_default_headers")
def get(self):
print("HTTP方法")
self.send_error(500)
return # send_error 之后不要再 write
self.write("sunck is a good man")
def write_error(self, status_code, **kwargs):
print("write_error")
self.write("服务器内部错误……")
def on_finish(self):
print("on_finish")send_error之后要return,否则继续write会撞上RuntimeError: Cannot write() after finish()(这条在 Tornado-请求与响应 里实测过)。- 老笔记这里写的是
self.send_error(500)后面紧跟self.write(...),那是错的示范。
模板与变量
-
模板目录由 settings 指定,
render()的返回值就是「渲染 + 结束响应」:config.py 1
2
3SETTINGS = {
"template_path": os.path.join(BASE_DIR, "templates"),
}views/index.py 1
2
3class HomeHandler(RequestHandler):
def get(self):
self.render("home.html", num=100, per={"name": "sunck", "age": 18}) -
传参两种写法,取法不同,实测都常用:
templates/home.html 1
2
3<h1>num: {{ num }}</h1>
<h1>num + 10: {{ num + 10 }}</h1>
<h1>{{ per['name'] }}</h1>views/index.py 1
self.render("home.html", num=100, **per) # 拆开传,模板里直接 {{ name }}
-
.和下标不能互换,这是 Tornado 模板和 Jinja、Django 模板最大的差别,实测两个方向都硬:1
2
3
4{{ per['name'] }} 字典 -> sunck 正常
{{ per.name }} 字典 -> AttributeError: 'dict' object has no attribute 'name'
{{ p.name }} 对象 -> attr 正常
{{ p['name'] }} 对象 -> TypeError: 'P' object is not subscriptable所以字典一律
d['k'],对象(包括 ORM 模型实例)一律obj.attr。老笔记「不能使用点语法」这句只对字典成立,别记成全局规则。
流程控制
-
if支持{% if %}/{% elif %}/{% else %},收尾都是{% end %}:1
2
3
4
5
6
7{% if flag == 1 %}
<h1>sunck is a good man</h1>
{% elif flag == 2 %}
<h1>kaige is a nice man</h1>
{% else %}
<h1>flag 不是 1 也不是 2</h1>
{% end %} -
for就是 Python 的for,可以直接上enumerate,实测:1
2
3
4
5{% for stu in stus %}
<li>{{ stu['name'] }}</li>
{% end %}
{% for k, v in enumerate(['a', 'b']) %}{{ k }}={{ v }} {% end %}1
0=a 1=b
-
老笔记的
while一节是空的,实测 Tornado 模板确实支持{% while %},但条件得自己推进,配合{% set %}用:1
2{% set i = 0 %}
{% while i < 3 %}[{{ i }}]{% set i += 1 %}{% end %}1
[0][1][2]
反过来,忘了推进就是死循环。实测写
{% while i < 3 %}x{% end %}且i不变,直接把内存吃光报MemoryError。 -
想「先干够再退出」,
break/continue也能用:1
2{% set i = 0 %}
{% while True %}{% set i += 1 %}{% if i > 2 %}{% break %}{% end %}[{{ i }}]{% end %}1
[1][2]
转义
-
Tornado 模板默认开自动转义,实测传
<h1>hi</h1>进模板:1
{{ s }} -> <h1>hi</h1>
-
关闭转义一共四种粒度,实测行为:
写法 作用范围 实测输出 {% raw s %}只这一处 <h1>hi</h1>{% autoescape None %}从这一行起,本文件内 <h1>hi</h1>settings 里 "autoescape": None整个项目 <h1>hi</h1>{{ escape(s) }}反过来:在已关转义的地方单独转义 <h1>hi</h1> -
两个必须知道的坑:
- 自动转义还开着时再调
escape()会转义两次,实测{{ escape(s) }}得到&lt;b&gt;,页面上显示成<b>。escape/xhtml_escape只在关掉自动转义的文件里才有意义。 json_encode也会被转义,实测{{ json_encode(d) }}(d={'a': 1})输出{"a": 1},塞进<script>里就废了。给 JS 传数据要写成{% raw json_encode(d) %}。
- 自动转义还开着时再调
-
settings里的autoescape只认None和函数名,传True/False会 500(TypeError: 'bool' object is not callable),这条在 Tornado-请求与响应 的 settings 一节有完整实测表。
继承与包含
-
基模板放骨架和
block,子模板extends后只填block,实测覆盖与不覆盖两种:templates/base.html 1
2
3
4
5
6
7
8
9
10
<html lang="en">
<head>
<meta charset="UTF-8">
<title>{{ title }}</title>
</head>
<body>
{% block main %}默认内容{% end %}
</body>
</html>templates/cart.html 1
2
3
4
5{% extends "base.html" %}
{% block main %}
<h1>这里是购物车页面</h1>
{% end %}1
2子页覆盖了 block -> <title>t</title>子页内容
子页没写 block -> <title>t</title>默认内容block里的内容就是「不覆盖时用的默认值」,这点和 Django 模板一致。 -
包含用
{% include %},实测:1
A{% include 'part.html' %}B -> A<span>片段</span>B
-
Jinja 那套
{% from 'x.html' import y %}在 Tornado 里不存在,实测编译期直接SyntaxError: invalid syntax。Tornado 的对应物是{% import "x.html" %}(执行那个模板并共享它的命名空间)和{% module %}。 -
{% module xsrf_form_html() %}这类模块只能在RequestHandler.render()的路子里用,直接拿tornado.template.Loader生成会NameError: name '_tt_modules' is not defined——因为模块需要请求上下文。XSRF 的细节见 Tornado-应用安全。
模板里的函数
-
static_url()由RequestHandler注入到模板命名空间,实测(static_path指向static/):templates/index.html 1
2<link rel="stylesheet" href="{{ static_url('css/home.css') }}">
<script src="{{ static_url('js/jquery.js') }}"></script>1
渲染结果 -> <link href="/static/css/home.css">
- 这里传的是不带前导斜杠的相对路径;写成
static_url('/css/home.css')在 6.6 会直接 403(实测:403 GET /: /css/common.css is not in root static directory)。 - 文件存在时它会带上
?v=<内容哈希>,配合Cache-Control: max-age=315360000做长期缓存;哈希每次读文件算,所以改文件不用改模板。
- 这里传的是不带前导斜杠的相对路径;写成
-
内置可用的名字,实测清单:
1
2
3len(xs) -> 3 str(x) -> 1 datetime.datetime(2026,1,1) -> 2026-01-01 00:00:00
json_encode(d) -> {"a": 1} url_escape('a b&c') -> a+b%26c
quote(u) -> NameError: name 'quote' is not defined也就是说常用的是
len/str/json_encode/url_escape/escape,quote这类没有;要更多功能就从 Python 侧传进来。 -
自定义函数就是当变量传进去,实测:
views/index.py 1
2
3
4
5
6class FuncHandler(RequestHandler):
def get(self):
def my_sum(n1, n2):
return n1 + n2
self.render("market.html", ms=my_sum)templates/market.html 1
<h1>{{ ms(100, 89) }}</h1>
1
-> 189
注意函数名按 PEP8 用下划线(
my_sum),别学老笔记写mySum。
静态文件
-
设了
static_path就自动有/static/(.*)路由,实测:1
GET /static/css/common.css -> 200 | Content-Type: text/css
模板里优先用
static_url(...)而不是硬写/static/...,前者带版本串。 -
想把某个目录直接挂到根路径(比如纯静态首页),用内置的
StaticFileHandler:application.py 1
2
3
4
5
6
7handlers = [
(r"/api/.*", ApiHandler),
# 兜底路由放最后,否则它会吃掉前面所有请求
(r"/(.*)", tornado.web.StaticFileHandler,
{"path": os.path.join(config.BASE_DIR, "static", "html"),
"default_filename": "index.html"}),
]实测:
1
2
3GET / -> 200 '<!DOCTYPE html>...Welcome to Tornado!...'
GET /index.html -> 200
GET /../css/common.css -> 403(越界被拦,日志:..\css\common.css is not in root static directory)path是提供文件的根目录,default_filename是「URL 没指到具体文件时兜底发哪个」。- 越界保护(
../)是内置的,不用自己写。 - 老笔记为了 XSRF 写了个
StaticFileHandler子类、在__init__里摸self.xsrf_token,实测带不带这段代码结果完全一样,没必要。
数据库
-
老笔记说「Tornado 没有自带 ORM,需要自己适配」,这句现在仍然对;但「Python3.6 + Tornado 还没有比较完善的驱动」早就过时了——Python 3.6 已停维,现在 SQLAlchemy 2.x 的同步和异步两条路都能用。
-
官方立场是「数据库自己选」,社区主流做法是 SQLAlchemy。推荐的摆法是引擎放应用上、session 一个请求一个:
db.py 1
2
3
4
5
6
7
8
9
10
11
12
13import os
from sqlalchemy import create_engine
from sqlalchemy.orm import declarative_base, sessionmaker
BASE_DIR = os.path.dirname(os.path.abspath(__file__))
engine = create_engine(
"sqlite:///" + os.path.join(BASE_DIR, "data.sqlite"),
pool_pre_ping=True, # MySQL 断连重连必备
)
Base = declarative_base()
SessionFactory = sessionmaker(bind=engine, expire_on_commit=False)models.py 1
2
3
4
5
6
7
8
9from sqlalchemy import Column, Integer, String
from db import Base
class Student(Base):
__tablename__ = "students"
id = Column(Integer, primary_key=True)
name = Column(String(20), unique=True)views/index.py 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17from db import SessionFactory
from models import Student
class DbHandler(RequestHandler):
def prepare(self):
self.db = SessionFactory()
def on_finish(self):
self.db.close() # 正好落在「收尾」这一步,不会漏
def get(self):
name = self.get_query_argument("name", "xiaoming")
if not self.db.query(Student).filter_by(name=name).first():
self.db.add(Student(name=name))
self.db.commit()
self.write({"names": [r.name for r in self.db.query(Student).all()]}) -
实测三次请求(第三次重复插
xiaoming):1
2
3/db?name=xiaoming -> {"names": ["xiaoming"]}
/db?name=xiaohua -> {"names": ["xiaoming", "xiaohua"]}
/db?name=xiaoming -> {"names": ["xiaoming", "xiaohua"]} # 没重复插环境是 SQLAlchemy 2.1.8 + SQLite。建表、迁移、连接串的写法与 Flask/Django 完全一致,细节见 Flask-邮件发送和数据模型,MySQL 驱动(
mysqlclient)的装法见 Django 系列。 -
prepare开、on_finish关这个搭配不是风格问题:on_finish在错误路径里也会被调用(见前面顺序表),所以放这里不会漏关。 -
同步查询会把整个事件循环卡住,这是 Tornado 用数据库最容易踩的坑。实测用一个
time.sleep(0.4)假装慢查询:1
2一个请求 0.40s
四个请求同时发 1.62s # 完全串行,等于没有异步三种解法,按侵入性从小到大:
-
把同步调用丢进线程池:
await IOLoop.current().run_in_executor(None, self.db.query(...).all),事件循环这段时间能去处理别的连接。 -
换异步驱动:SQLAlchemy 2.x 的
create_async_engine+asyncpg(PostgreSQL)/aiomysql(MySQL),handler 里async def get一路await。 -
业务本来就短(主键查询几毫秒)时,同步也够用,但要知道「一个慢查询会拖全服」这条底线。
-
老笔记还画了第四种:干脆把 SQL 挪到另一个「数据服务器」里,Tornado 只用
AsyncHTTPClient去请求它。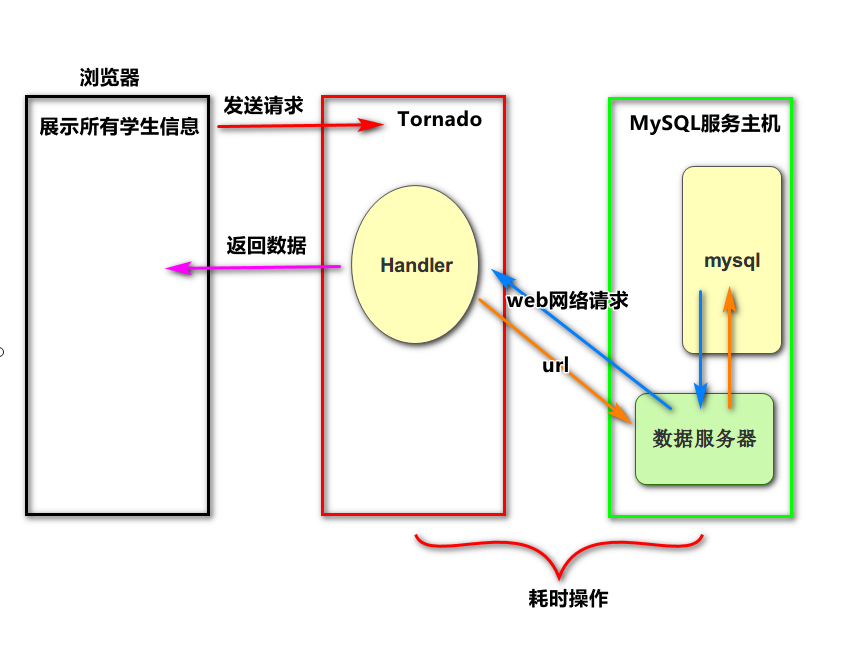
这套在当年(没有成熟异步驱动时)确实管用,代价是多一个服务要部署、要鉴权。今天除非本来就有中台,否则用上面三种就够了。
-
-
老笔记说「应用启动时建一个数据库连接实例供各 handler 用」——方向对,但要精确成「引擎/连接池放应用上(线程与协程共享),session 一个请求一个」。全局共享一个 session 会在并发下互相污染。