Tornado-同步与异步以及使用WebSocket实现在线聊天
这篇讲什么
- 用同一段「0.5 秒耗时操作 + 0.2 秒另一个请求」把同步、回调、生成器协程、
async/await四种写法串起来,看它们各自耗时多少、日志顺序怎么变。 - Tornado 侧的异步:
AsyncHTTPClient的用法与响应字段,以及一个容易误解的点——并发收益取决于上游是否让出事件循环,实测差距是 1.22 秒对 0.32 秒。 - WebSocket:握手与 101 的原始报文、
WebSocketHandler各方法签名、在线聊天的完整实现(服务端 + 前端),以及check_origin、ping_interval、max_message_size这几个生产开关的实测行为。
同步为什么慢
-
最朴素的写法,两件事排队做:
sync_demo.py 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import time
def long_io():
print("开始耗时操作")
time.sleep(0.5)
print("结束耗时操作")
return "data"
def req_a():
print("A 开始")
res = long_io()
print("A 收到", res)
print("A 结束")
def req_b():
print("B 开始")
time.sleep(0.2)
print("B 结束")
req_a()
req_b()1
2顺序执行耗时 0.70s
日志: A 开始 | 开始耗时操作 | 结束耗时操作 | A 收到 data | A 结束 | B 开始 | B 结束 -
关键就在
time.sleep(0.5)这段时间里线程什么都干不了:B 必须等 A 全做完。Web 服务里等价的情形是「handler 里同步等数据库/等上游接口」,一个慢请求会把同进程里所有请求都堵住(上一篇的实测里,四个并发请求耗时 1.22 秒 ≈ 4 × 0.3 就是这个现象)。
异步的三种写法
-
思路都一样:把耗时操作交给别人,自己先往下走,结果回来时再通知你。
-
写法一:回调(老笔记的第一种,仍然最能说明「谁在等谁」)
callback_demo.py 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24import threading
import time
def long_io(callback):
def run():
print("开始耗时操作")
time.sleep(0.5)
print("结束耗时操作")
callback("data")
threading.Thread(target=run).start()
def req_a():
print("A 开始")
long_io(lambda d: print("回调收到", d))
print("A 结束")
req_a()
time.sleep(0.2)
print("B 结束")
time.sleep(0.4)1
2总耗时 0.60s
日志: A 开始 | 开始耗时操作 | A 结束 | B 结束 | 结束耗时操作 | 回调收到 data- 收益确实有了(0.60 < 0.70),代价是「A 结束」打印在结果之前,逻辑被切成两半;再嵌套两层就是回调地狱。
-
写法二:生成器协程(老笔记的版本 1/2/3 是在推这条思路,方向对,但里面有个全局
gen变量,那是它自己列出的问题)gen_demo.py 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41import threading
import time
def long_io():
print("开始耗时操作")
time.sleep(0.5)
print("结束耗时操作")
yield "data"
def gen_coroutine(func):
def wrapper(*args, **kwargs):
outer = func() # req_a 的生成器
inner = next(outer) # 拿到 long_io 的生成器
def run():
res = next(inner)
try:
outer.send(res) # 把结果塞回去
except StopIteration:
pass
threading.Thread(target=run).start()
return wrapper
def req_a():
print("A 开始")
res = yield long_io()
print("A 收到", res)
print("A 结束")
req_a()
print("B 开始")
time.sleep(0.2)
print("B 结束")
time.sleep(0.4)1
2总耗时 0.60s
日志: A 开始 | 开始耗时操作 | B 开始 | B 结束 | 结束耗时操作 | A 收到 data | A 结束- 好处是
res = yield long_io()看起来像同步写法;坏处是「调用它时不能当普通函数用」——老笔记版本 1 记的这个问题是真的,必须靠装饰器把next()/send()藏起来。
- 好处是
-
写法三:
async/await(现在唯一推荐写的)async_demo.py 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import asyncio
async def long_io():
print("开始耗时操作")
await asyncio.sleep(0.5)
print("结束耗时操作")
return "data"
async def req_a():
print("A 开始")
res = await long_io()
print("A 收到", res)
print("A 结束")
async def req_b():
print("B 开始")
await asyncio.sleep(0.2)
print("B 结束")
async def main():
await asyncio.gather(req_a(), req_b())
asyncio.run(main())1
2两个任务并发总耗时 0.52s(串行要 0.7s)
日志: A 开始 | 开始耗时操作 | B 开始 | B 结束 | 结束耗时操作 | A 收到 data | A 结束- 注意这里换的是
await asyncio.sleep(),不是time.sleep():前者让出事件循环,后者只是把线程睡死。 - 一个反直觉的点:
await只在并发发起时才省时间。同一个协程里连写两个await(各 0.5 秒)仍然是 1 秒,要asyncio.gather(...)才能压到 0.5 秒。
- 注意这里换的是
Tornado 里的异步请求
-
老笔记说「epoll 主要解决网络 IO 并发,所以 Tornado 的异步主要体现在网络 IO 上」,方向对;现代说法是:Tornado 的异步 = asyncio 的异步,网络请求、定时、锁、队列都能
await。 -
客户端就是
AsyncHTTPClient,实测签名:1
2
3
4AsyncHTTPClient().fetch(request, raise_error=True, **kwargs) -> Future[HTTPResponse]
HTTPRequest(url, method, headers, body, auth_username, auth_password, auth_mode,
connect_timeout, request_timeout, if_modified_since, follow_redirects,
max_redirects, user_agent, ...)request可以是 URL 字符串,也可以是HTTPRequest对象;传字符串时会自动造一个。raise_error是fetch()的参数,不是HTTPRequest的参数,写进去直接TypeError(我踩过)。
-
响应对象
HTTPResponse的字段实测:1
2
3code=200 reason='OK' error=None effective_url='http://127.0.0.1:8943/?tag=one'
body 类型: bytes 值: {"tag": "one"}
time_info 键: []body是 bytes,json.loads(res.body)可以直接吃。- 状态码非 2xx/3xx 时默认抛
HTTPClientError: HTTP 404: Not Found;要拿到响应体就传raise_error=False。 time_info在默认的SimpleAsyncHTTPClient下是空的,装了 pycurl 走CurlAsyncHTTPClient才有分段耗时。
-
老笔记用的豆瓣接口现在需要登录态和反爬处理,本机不保证能通;测并发用本地接口更可靠,实测(上游每个请求 0.3 秒):
1
2单个请求 0.31s;四个并发 1.22s # 上游 handler 里用 time.sleep(0.3)
单个请求 0.32s;四个并发 0.32s # 上游改成 await asyncio.sleep(0.3)客户端并发不等于系统并发:上游是单进程且阻塞在
time.sleep时,四个请求只能排队。所以「Tornado 慢」的锅经常不在客户端写法,而在被调的那一端没让出事件循环。 -
非把同步调用放进 handler 不可时,用线程池挪开,实测四个请求同样只花 0.31 秒:
views/index.py 1
2
3
4
5class MixedHandler(RequestHandler):
async def get(self):
loop = asyncio.get_event_loop()
await loop.run_in_executor(None, lambda: time.sleep(0.3))
self.write({"mode": "executor"}) -
老笔记那三种「实现异步」的代码在 6.6 上还能跑(
@tornado.gen.coroutine+yield、raise tornado.gen.Return(ret)都实测 200),但它们已经是兼容层:-
tornado.gen.coroutine/multi/Return/sleep/convert_yielded实测都还在;maybe_wait_for已没有。 -
tornado.web.asynchronous装饰器已删除(实测hasattr(tornado.web, 'asynchronous')为 False)。老笔记说「报这个错就退回 tornado==5.1.1」是错的解法:6.x 里async def get天然就不会在处理完之前关闭连接,不需要任何装饰器。 -
raise gen.Return(ret)只是把值返回给调用方,不会自动写响应,实测这样写会返回 200 但响应体是空的;要输出必须self.write(...)。legacy_gen.py 1
2
3
4
5
6
7
8
9
10
11
12
13
14# 兼容层写法,只为说明坑,新代码直接 async def + return
class GenReturnHandler(RequestHandler): # /gr
def get(self):
ret = {"ret": 1}
raise tornado.gen.Return(ret) # 只是 return 给调用方
class GenReturnWritesHandler(RequestHandler): # /grw
def get(self):
ret = {"ret": 2}
self.write(ret) # 想输出必须自己 write
raise tornado.gen.Return(ret)1
2/gr -> code=200 长度=0 body=b''
/grw -> code=200 长度=10 body=b'{"ret": 2}'
-
实时拿到消息的三种做法
-
三种方式的取舍:
- 短轮询:前端定时
setInterval问一次。简单,但大部分请求都是空答,延迟取决于间隔。 - 长轮询:服务端没更新就一直挂着,有更新立刻返回;返回后前端马上再挂下一次。
- WebSocket:一条 TCP 连接双向常驻,服务端可以直接推。
- 短轮询:前端定时
-
长轮询可以只用
asyncio写出来,实测:views/index.py 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15EVENT = asyncio.Event()
UPDATES = []
class PollHandler(RequestHandler):
async def get(self):
timeout = float(self.get_query_argument("timeout", "2"))
try:
await asyncio.wait_for(EVENT.wait(), timeout)
except asyncio.TimeoutError:
self.write({"updates": [], "why": "timeout"})
return
EVENT.clear()
out, UPDATES[:] = list(UPDATES), []
self.write({"updates": out, "why": "hit"})1
2
3没人推送,挂到超时: 1.02s {"updates": [], "why": "timeout"}
0.4 秒后有人推送: 0.42s {"updates": ["新消息"], "why": "hit"}
推送已被取走,再挂到超时: 1.01s {"updates": [], "why": "timeout"}- 「有更新 0.42 秒就返回」就是长轮询的价值:延迟低,且没有更新时不重复问答。
- 注意挂住的每个请求都占着一个连接,服务端要设超时(上面用
wait_for),否则连接会一直堆着。
-
老笔记「前端轮询:有数据立即回复,没数据就回复没数据;长轮询:没有数据改变时不做任何响应」这句区分是对的。
WebSocket 协议
-
老笔记几条描述仍然成立,逐条对一下:
- WebSocket 是独立的协议,跑在 TCP 之上,用
ws://(加密用wss://) scheme。 - 它和 HTTP 的关系就是那次升级握手:客户端发
Upgrade: websocket,服务端回101 Switching Protocols,之后这条 TCP 连接就不再走 HTTP 语义。 - 默认端口就是 80/443(沿用 HTTP 的端口),所以能穿过大多数防火墙。
- WebSocket 是独立的协议,跑在 TCP 之上,用
-
原始握手报文实测(手写的
GET /echo升级请求):1
2
3
4
5
6HTTP/1.1 101 Switching Protocols
Server: TornadoServer/6.6
Date: Fri, 06 Nov 2026 11:14:50 GMT
Upgrade: websocket
Connection: Upgrade
Sec-Websocket-Accept: s3pPLMBiTxaQ9kYGzzhZRbK+xOo=Sec-WebSocket-Accept是客户端Sec-WebSocket-Key拼上固定 GUID 后做 SHA-1 再 base64 的结果,用来证明服务端真的理解了这个协议(这里用的正是 RFC 6455 里的示例值)。 -
握手不完整时 Tornado 直接拒,实测:
1
2只带 Upgrade 没带 Connection -> 400 "Connection" must be "Upgrade".
普通 GET 打 WebSocket 路由 -> 400 Can "Upgrade" only to "WebSocket".
WebSocketHandler
-
方法清单(签名按 6.6 实测,老笔记那份有几处过时):
方法 实测签名 什么时候走 open(self, *args, **kwargs)握手成功后 on_message(self, message: str | bytes)收到一帧 on_close(self)连接关闭后 write_message(message: bytes | str | dict, binary=False)主动下发,返回 Future close(code=None, reason=None)关闭连接 check_origin(self, origin: str)握手前决定放不放行 on_ping/on_pong(self, data: bytes)收到 ping / pong ping(self, data=b'')主动发 ping select_subprotocol(self, subprotocols: list[str])协商子协议 - 老笔记写的是
WebSocketHandle,正确类名是WebSocketHandler。 - 服务端没有
receive_messages()(实测hasattr为 False),那是客户端连接对象上的东西;服务端就是on_message回调。 write_message可以直接传 dict,实测会被json_encode成文本帧。
- 老笔记写的是
-
二进制帧要显式指定,实测同一个客户端连接:
1
2
3write_message("hi") 服务端 on_message 看到 kind=str len=2
write_message(b"\x00\x01\x02", binary=True) 服务端 on_message 看到 kind=bytes len=3
write_message(b"\x00\x01\x02") 服务端 on_message 看到 kind=str len=3 # 被当文本发出去了也就是说传 bytes 不等于发二进制帧,必须
binary=True。 -
断线之后别再写,实测
close()之后再write_message不会抛异常,但消息被丢掉(返回的 Future 也不会完成),所以要靠on_close把自己从在线列表里摘掉。
在线聊天
-
服务端:
users用set而不是list,摘人时不会因为「不在集合里」抛ValueError(老笔记用list.remove就有这个隐患)。views/index.py 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import tornado.web
import tornado.websocket
from tornado.web import RequestHandler
from tornado.websocket import WebSocketHandler
class HomeHandler(RequestHandler):
def get(self):
self.render("home.html")
class ChatHandler(WebSocketHandler):
clients = set()
def open(self):
ChatHandler.clients.add(self)
self.broadcast("[%s]登陆了" % self.request.remote_ip)
def on_message(self, message):
self.broadcast("[%s]说:%s" % (self.request.remote_ip, message))
def on_close(self):
ChatHandler.clients.discard(self)
self.broadcast("[%s]退出了" % self.request.remote_ip)
def broadcast(self, text):
for client in list(ChatHandler.clients):
client.write_message(text)application.py 1
2
3
4handlers = [
(r"/", HomeHandler),
(r"/chat", ChatHandler),
] -
前端不再需要 jQuery:
templates/home.html 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
<html lang="zh-CN">
<head>
<meta charset="UTF-8">
<title>聊天界面</title>
</head>
<body>
<div id="contents" style="width:500px;height:500px;overflow:auto"></div>
<div>
<input type="text" id="message"/>
<button onclick="sendMessage()">发送</button>
</div>
<script>
const ws = new WebSocket("ws://127.0.0.1:8848/chat");
ws.onmessage = function (e) {
const p = document.createElement("p");
p.textContent = e.data;
document.getElementById("contents").append(p);
};
function sendMessage() {
const box = document.getElementById("message");
ws.send(box.value);
box.value = "";
}
</script>
</body>
</html>- 用
textContent而不是老笔记的append("<p>" + e.data + "</p>"):后者会把消息当 HTML 拼进去,别人发<img onerror=>就是存储型 XSS。 - 地址要写
ws:///wss://;上线走 HTTPS 时浏览器不允许再连明文ws://,必须用wss://,并由 nginx 转发Upgrade头。
- 用
-
用 Tornado 自己的客户端跑一遍完整流程,实测:
1
2
3
4
5
6
7A 连上收到: [127.0.0.1]登陆了
B 连上后,A 又收到: [127.0.0.1]登陆了
B 收到: [127.0.0.1]登陆了
A 发 hello -> A: [127.0.0.1]说:hello | B: [127.0.0.1]说:hello
A 发 JSON 字符串 -> B: [127.0.0.1]说:{"k": 1}
B 断开 -> 群里收到: [127.0.0.1]退出了
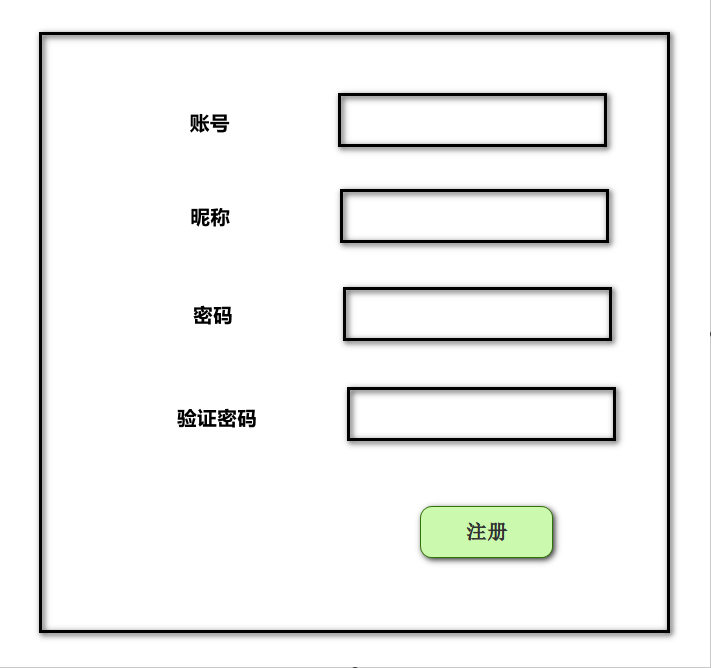
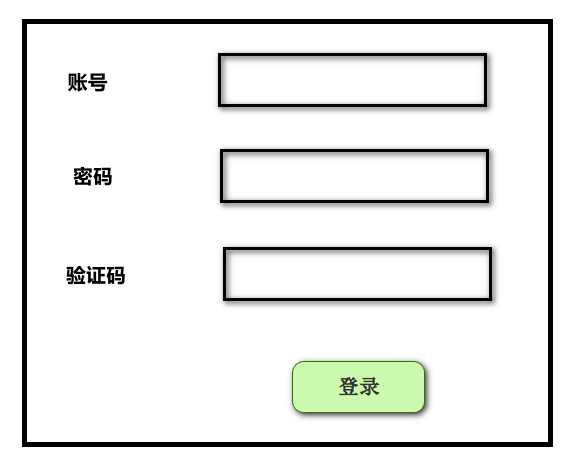
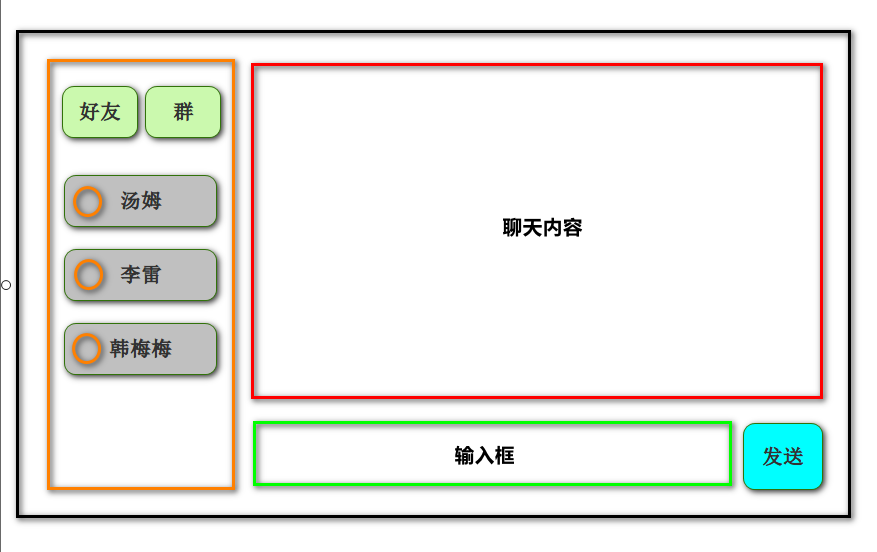
在线人数: 1登录、聊天界面的截图(老笔记留的三张图)对应的就是这条链路:
生产开关
-
check_origin决定谁能连,默认实现只放同源,实测:1
2
3不带 Origin 头(非浏览器客户端) -> 放行
Origin: http://evil.example -> 403 Forbidden(握手直接失败)
Origin: http://127.0.0.1:8946 -> 放行老笔记里那句
def check_origin(self, origin): return True是「无条件放行任意站点」,等于放弃这层保护;要跨站就自己列白名单:views/index.py 1
2
3
4
5class ChatHandler(WebSocketHandler):
ALLOWED = {"http://127.0.0.1:8848", "https://suyin-blog.cn"}
def check_origin(self, origin):
return origin in self.ALLOWED实测覆盖成「只放同源」之后,跨站连接同样是
HTTPClientError: HTTP 403: Forbidden。 -
心跳:
websocket_connect/Application都能配ping_interval、ping_timeout(服务端属性是ping_interval、ping_timeout)。实测有个坑:1
2The websocket_ping_timeout (1) cannot be longer than the websocket_ping_interval (0.3).
Setting websocket_ping_timeout=0.3也就是
ping_timeout大于ping_interval时会被自动压到 interval,并打一条警告。配ping_interval=0.3后空闲 1 秒连接依然活着,实测能正常收发。 -
消息大小:服务端默认上限 10MB(
max_message_size),实测发 200 字节正常收到(got 200)。超限的连接会被断开,所以传大文件别走 WebSocket 文本帧,走上传接口。 -
多进程/多机下
clients这个类属性只在当前进程有效:实测start(4)之后不同 worker 各自维护自己的在线列表,A 连在 worker1、B 连在 worker2 就互相广播不到。要跨进程得把「谁在线、消息发给谁」挪到共享存储(Redis 发布订阅、或者独立的推送服务)。 -
XSRF 与 WebSocket:握手是
GET,check_xsrf_cookie对 GET 不生效,所以 WebSocket 的鉴权要在open()里自己查登录态(self.current_user,配合上一篇的get_current_user),未登录直接self.close()。