Django-云环境中的部署
这篇讲什么
- 这一篇讲的是「把 Django 放进云和容器里」:Docker 镜像怎么构建、docker compose 怎么把 web/redis/celery 一起拉起来、Kubernetes 的组件与声明式配置长什么样、云上怎么做监控与日志采集。
- 必须先说清楚边界:本机没有容器运行时(Docker / k8s / 云账号都没有),所以容器与云平台的步骤全部按官方文档写,属可复制的参考配置,未在本机验证。能实测的部分(进程守护、反向代理、静态托管、密钥注入、监控指标)都已经挪到《在宝塔上部署 Django 项目》《Django-应用水平扩展》《Django-接入监控告警》里,那三篇的每条结论都有本机输出。
- 未在本机验证:Docker 镜像构建、
docker compose、Kubernetes、kompose、阿里云 ACK/SLS/Logtail、镜像加速。 - 已实测并可直接照抄:Gunicorn + systemd + Nginx、Nginx 分流与健康检查、Prometheus 抓取、Sentry SDK 事件结构。
- 官方文档在本机部分页面拿不到响应(
docs.docker.com/compose/*返回连接失败,而docs.docker.com/engine/、get-started/docker-overview/正常),所以下面引用官方页时以「页名 + 站点」表述,链接照官方地址给,具体路径以你能打开的版本为准。
什么时候值得上容器
| 场景 | 建议 | 理由 |
|---|---|---|
| 一台 VPS、单应用、团队小 | systemd + Nginx(不用容器) | 组件少、排错直接,实测路线见《在宝塔上部署 Django 项目》 |
| 开发环境要「一条命令起全套」 | docker compose | 应用 + Redis + Celery + Flower 一起拉起 |
| 多服务、多环境、要滚动发布 | 容器 + 编排(k8s 或云托管) | 一致交付、自动扩缩、健康检查 |
| 需要 GPU/大内存单机推理 | 别容器化 | 驱动与资源隔离的坑多于收益 |
容器带来的真实收益是环境一致性(开发/预发/线上同一镜像),不是性能。性能与并发能力仍然取决于 worker 数、数据库与缓存,见《Django-让网站访问更快》。
二、Docker 基础用法(官方文档口径,未在本机验证)
准备工作
- 安装 Docker(官方 Get started 与 Engine 文档)。
- 国内网络可以配置镜像加速(阿里云提供官方仓库的加速地址,需要自己的账号开通)。注意:加速地址会随政策变动,配不上就换官方源或自建代理,别在
daemon.json里堆多个失效地址。
常用命令
1 | $ docker pull <镜像名> # 拉取镜像 |
老笔记里 docker ps:查看有哪些镜像正在运行 这句要改成「查看正在运行的容器」——镜像是不会「运行」的。
端口映射与卷
1 | $ docker run -d -p 宿主机端口:容器端口 django-docker |
-p 是端口转发,-v 是挂载目录(容器重建后数据仍在宿主路径)。gogs 这个例子就是「用一个现成镜像快速起一个带持久化目录的服务」,理解这两条参数就够入门了。
三、Dockerfile:Django 应用的镜像怎么建
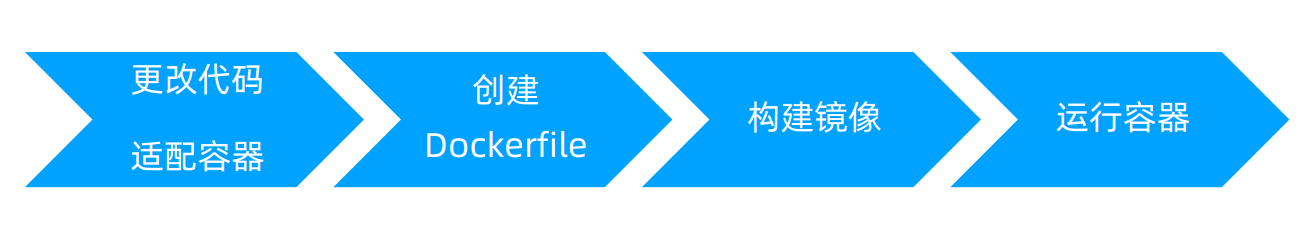
官方入门例子的两个时代问题
老笔记抄的是 Docker 官方 Flask 入门(python:3.7-alpine),3.7 早已停止维护,现在按官方教程走会撞上一堆依赖装不上。基础镜像要选仍在支持期的版本,Django 5.2 支持 Python 3.10~3.13。
另外一个现实问题:alpine 上装带 C 扩展的包很痛苦。mysqlclient、Pillow、psycopg2 在 alpine 需要额外装 mysql-dev/musl-dev/gcc 等一堆构建依赖,而 Debian 系的 slim 镜像装起来顺利得多。所以下面给两个版本。
3.2 推荐版:Debian slim + Gunicorn
1 | FROM python:3.12-slim |
要点:
PYTHONUNBUFFERED=1必须设,否则docker logs半天看不到输出(日志被缓冲)。- 构建依赖装在同一个
RUN里,配合--no-install-recommends与清理 apt 列表,层数少、体积小。 - 非 root 用户运行(
USER app),K8s 的安全策略也要求这个。 collectstatic放构建期,运行时只读挂载即可。- 迁移不要写进
CMD,多副本会同时迁移;发布时单独执行一次。
老笔记的 alpine 版
1 | FROM python:3.12-alpine |
对照原文要改的地方:
start.local.bat是 Windows 批处理,容器里应该用.sh。.dockerigonre→.dockerignore(把db.sqlite3、.git、staticfiles、__pycache__、本地venv排掉,镜像能小一大截)。- 原 Dockerfile 里
apk add curl jq py3-configobj py3-pip py3-setuptools这些和 Django 无关,属于误抄,删掉更干净。
构建与运行
1 | $ docker build -t myapp/recruitment:1.0.0 . |
配置项一律走环境变量,不要把 settings.local 之类的分支写死进镜像。老笔记里 ALLOWED_HOSTS = ['*'] 的写法在容器里同样不该用,改成 DJANGO_ALLOWED_HOSTS 注入(原因和实测的 400 行为见《Django-生产环境要注意哪些事项》1.2)。
四、docker compose:单机编排多个容器
典型组合
一个 Django 项目常见的四个服务:
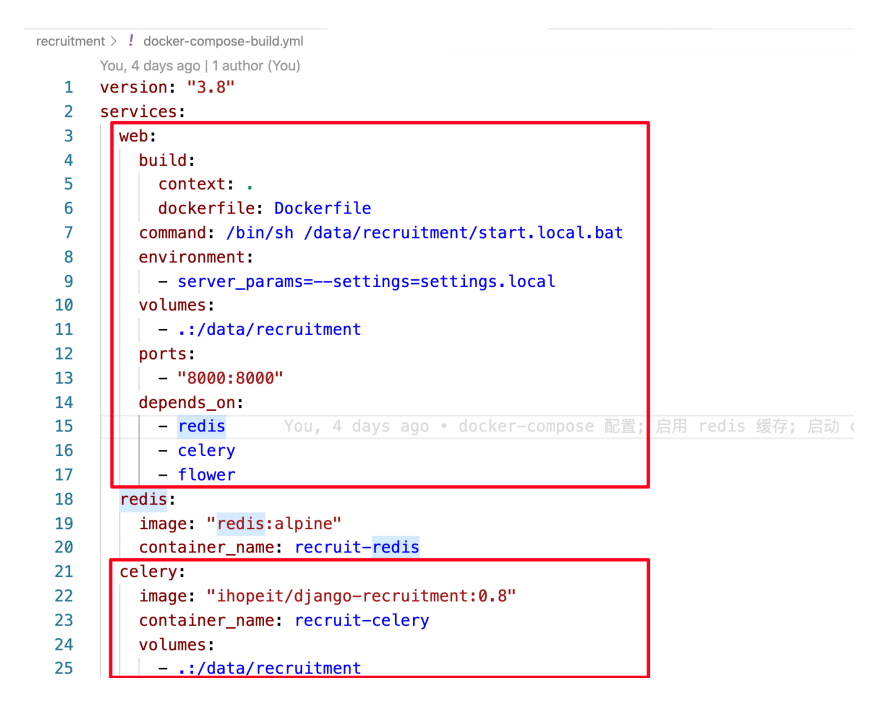
web:Gunicorn 跑 Django。redis:缓存 + Celery broker。celery:异步任务 worker。flower:Celery 的监控面板。
参考配置
1 | services: |
与老配置的差异,都是现在官方推荐的写法:
- 不再写
version: "3.2"。Compose V2 里这个字段已废弃,写了会有 warning,迁移细节见站内《Compose-V2-入门》。 - 命令是
docker compose(中间空格),不是docker-compse up –d(老笔记这里既有拼写错误,又把减号写成了中文破折号)。 depends_on只控制启动顺序,不等服务就绪;要等就绪必须写condition: service_healthy+ 给被依赖服务配healthcheck。这是「容器起来了但 Django 报连不上数据库」的头号原因。- 密钥用
env_file/secrets,不要写进environment明文(environment会出现在docker inspect里)。
常用命令:
1 | $ docker compose up -d # 启动 |
五、Docker、compose、Swarm、K8s 的关系
| 东西 | 层次 | 管什么 |
|---|---|---|
| Docker / containerd | 运行时 | 单个容器怎么跑起来 |
| docker compose | 单机编排 | 一台机器上一组容器的关系 |
| Swarm | 集群编排(Docker 自家) | 多机服务调度,现处于维护状态 |
| Kubernetes | 集群编排(事实标准) | 多机调度、自愈、扩缩容、服务发现 |
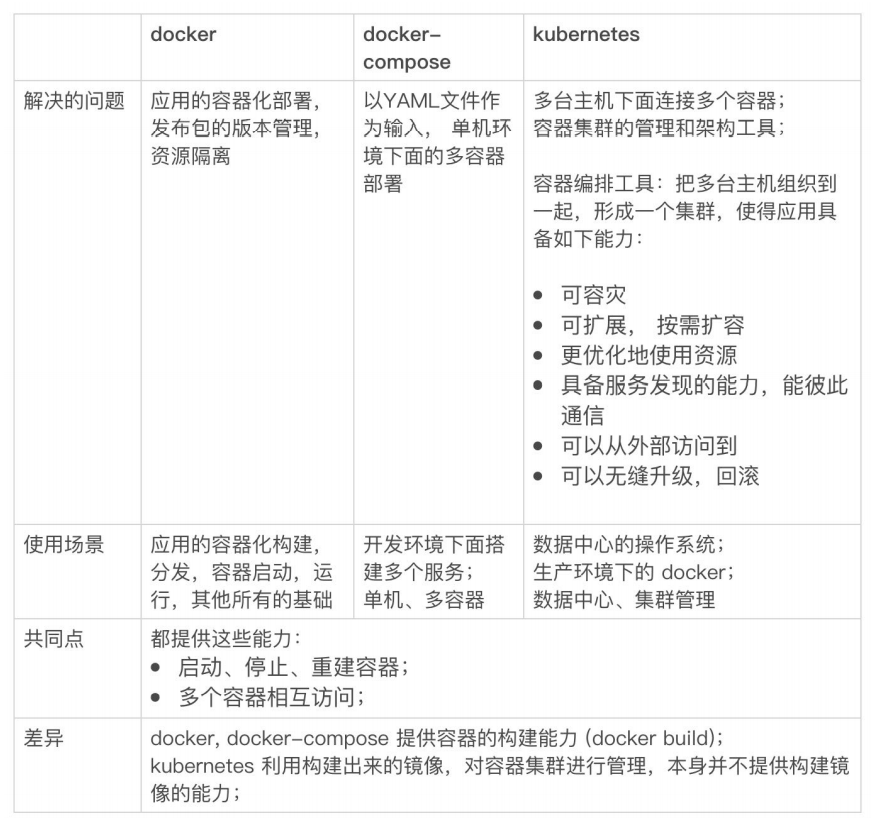
一句话:compose 解决「一台机器上多个容器怎么一起跑」,k8s 解决「一个集群上多个服务怎么活着」。中间还有云厂商的托管方案(ACK/GKE/ECS 等),本质是替你管控制面。
Kubernetes 的架构与核心概念
- 本节按官方文档口径整理,未在本机起过 k8s 集群。
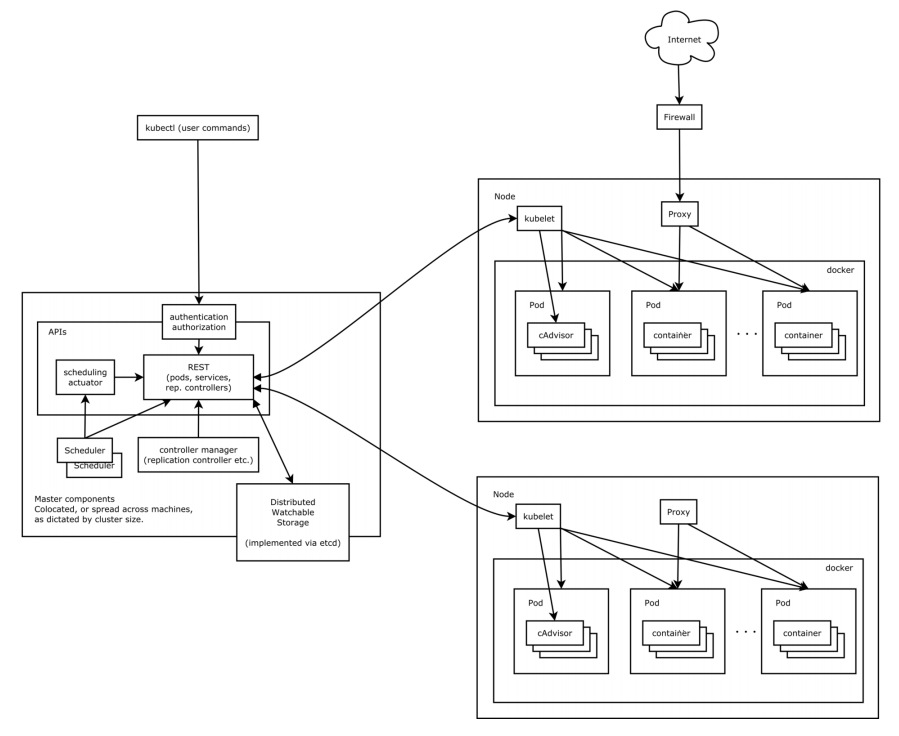
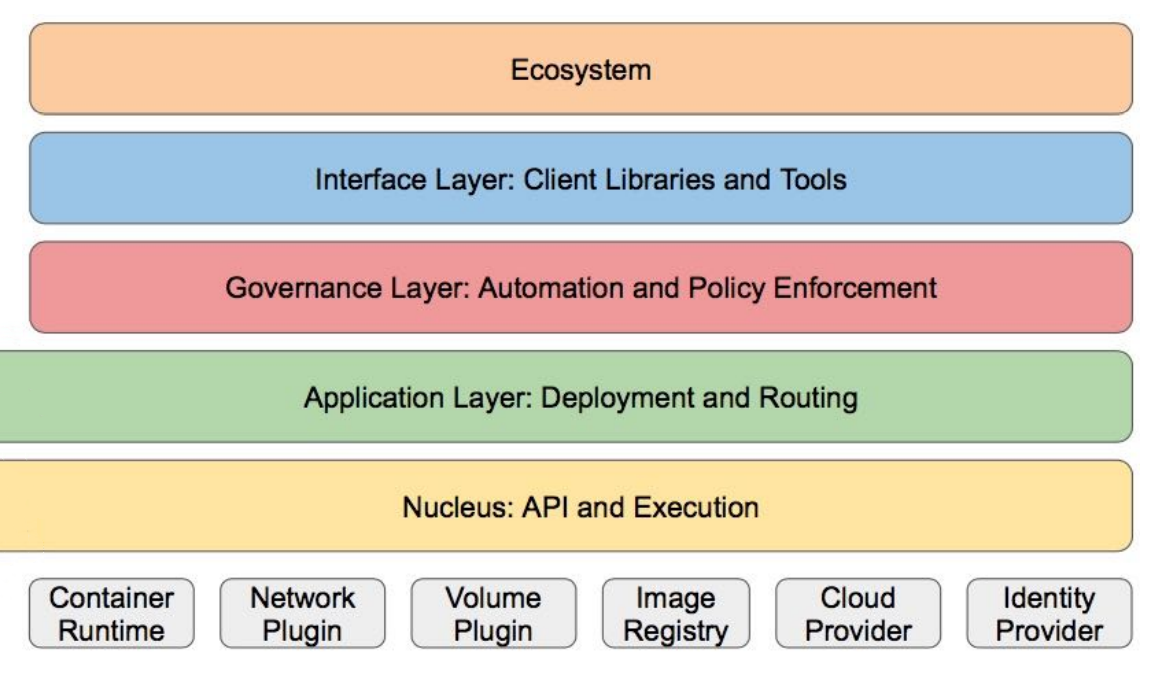
6.1 分层
- 核心层:API Server 提供接口,etcd 存状态,控制器提供执行环境。
- 应用层:Deployment / StatefulSet / Job / Service / Ingress 这些工作负载与路由抽象。
- 管理层:度量(资源、网络)、自动化(HPA 扩缩容、Provisioning)、策略(RBAC、Quota、NetworkPolicy、Pod 安全标准)。
核心组件
kube-apiserver:唯一入口,所有请求经它校验后写 etcd。etcd:集群状态的键值存储。kube-scheduler:决定 Pod 落到哪个节点。kube-controller-manager:各类控制器(副本数、节点、端点)。kubelet:节点上真正拉起容器的代理。kube-proxy:Service 的流量转发规则。
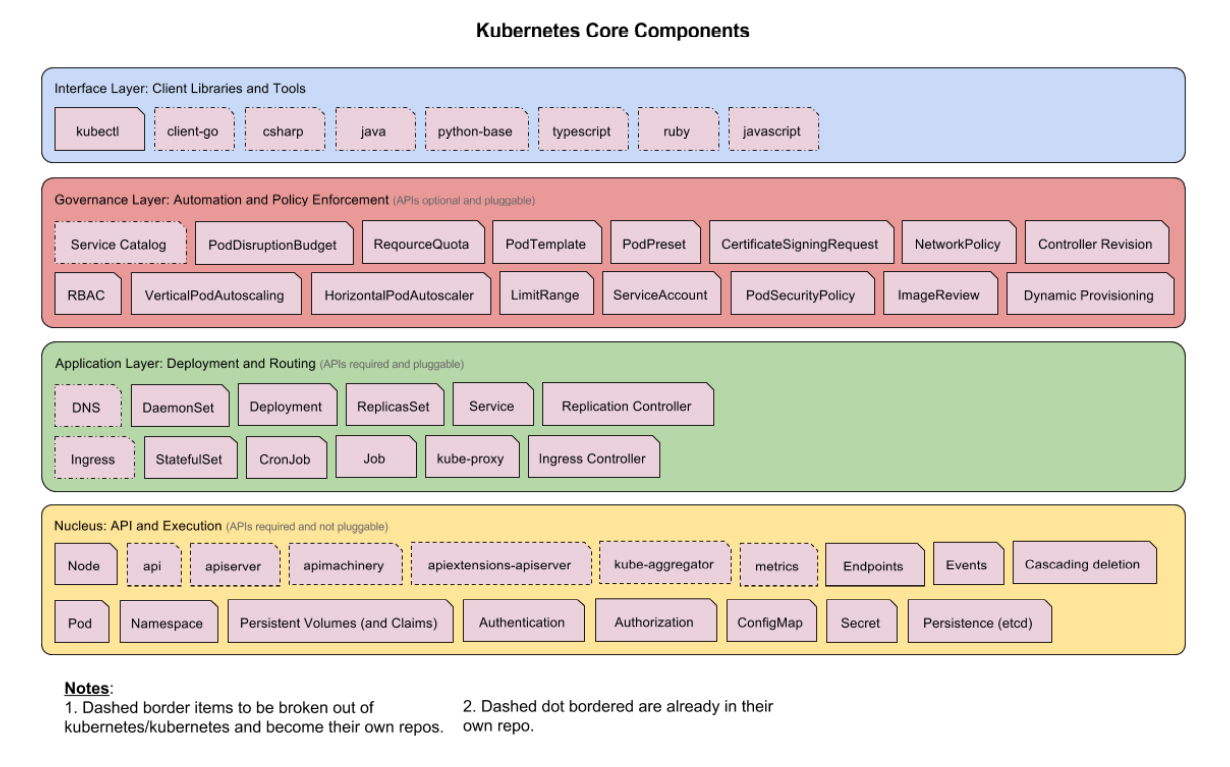
核心概念
- 声明式 vs 命令式:
kubectl apply -f xxx.yaml声明期望状态,控制器负责收敛;kubectl run/kubectl expose是命令式,临时调试用。 - Pod:最小调度单位,一个 Pod 可含多个容器,共享网络与存储。
- Deployment + ReplicaSet:无状态服务的滚动升级与副本数管理(ReplicaSet 一般不手写,由 Deployment 生成)。
- StatefulSet(老笔记拼成
StatefullSet):有状态服务,Pod 名与存储卷稳定绑定,如zk-0/zk-1/zk-2。 - Service:给一组 Pod 一个稳定的集群内入口(ClusterIP / NodePort / LoadBalancer)。
- Ingress:七层对外入口,按域名/路径路由到 Service。
- Namespace:资源隔离与配额边界。
- ConfigMap / Secret:配置与密钥,Secret 只是 base64,生产要开加密静态存储或用外部 KMS。
- HPA:按指标自动扩缩副本。
Django 在 k8s 里的典型形态:Deployment(web, gunicorn) + Service + Ingress + ConfigMap/Secret + Deployment(celery worker) + 外部数据库(不建议把生产数据库塞进集群)。
从 compose 生成 k8s 清单
老笔记这段命令有三处抄错(URL 被换行截断、chmod +x compose 少了 k、mkidr 拼错),修正后:
1 | $ curl -L https://github.com/kubernetes/kompose/releases/download/v1.35.0/kompose-linux-amd64 -o kompose |
版本号请以 kompose releases 页面当前值为准(本机没有 k8s 集群,这段未执行)。kompose convert 生成的清单只是起点,探针、资源限额、PDB、Service 类型都要手工补。
6.5 云上托管集群的部署流程(阿里云 ACK 为例,控制台操作未验证)
- 创建 Kubernetes 集群与镜像仓库(ACR)命名空间。
- 把集群的
kubeconfig配到本地,kubectl get nodes能列出节点。 docker login镜像仓库。docker build+docker tag+docker push把镜像推进仓库。kubectl apply -f k8s部署,或走云上的 CI/CD 流水线(见《Django-云环境中的持续集成》)。- 在控制台或用
Ingress配置对外路由,指向 Django 服务。
云环境里的监控
容器化之后,「登进机器看日志」这条路基本废了:实例随时被销毁,文件系统不持久。可观测性要靠三件事:指标、日志、分布式追踪。
| 手段 | 用途 | 备注 |
|---|---|---|
kubectl get/describe/logs |
临时排障 | 只能看当下,Pod 没了就没了 |
| Kubernetes Dashboard / 云控制台 | 集群层面的状态 | 看事件、资源水位 |
| Prometheus + Grafana | 指标与告警 | 接入方式与实测数字见《Django-接入监控告警》 |
| Sentry | 异常事件 | 与集群无关,容器里照样上报 |
| ELK / Loki / SLS | 日志集中检索 | 必须让应用把日志打到 stdout |
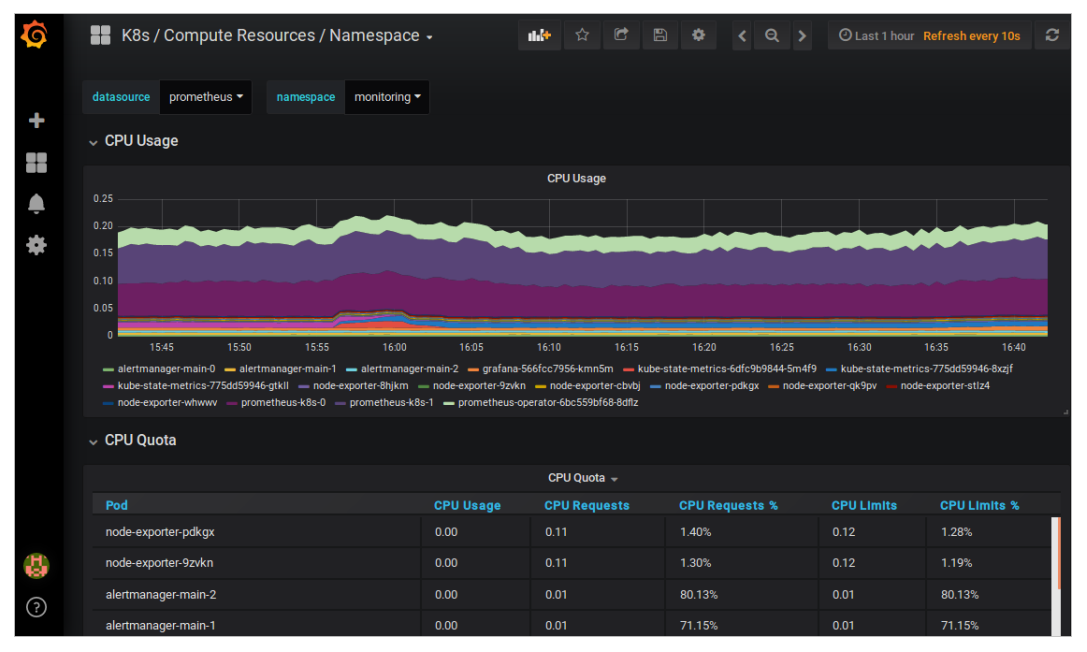
阿里云 ACK 上跑 Prometheus 的官方做法是装 ack-prometheus-operator,然后本地端口转发查看(控制台/命令行操作,未验证):
1 |
|
Django 侧要做的只有一件事:暴露 /metrics(本机已实测抓取链路可用,见《Django-接入监控告警》4.3)。
云环境里的日志采集
k8s 里有哪些日志
- Pod 日志:
kubectl logs,容器 stdout/stderr 由 kubelet 落到节点/var/log/containers/。 - 节点日志:
journalctl、/var/log/下的系统日志。 - 组件日志:apiserver、scheduler 等,默认在
/var/log下。 - Events:调度与镜像拉取失败等事件,
kubectl get events。 - Audit logs:API 审计,需要显式开启。
结论:应用日志一律写 stdout/stderr,别自己滚文件。这一条在 WSL 上实测过(gunicorn accesslog="-" 之后 journald 直接收到访问行),容器里同理,采集端只需要盯 stdout。
两种采集模式
- DaemonSet 采集器(Logtail / Filebeat / Fluent Bit):每个节点一个 agent,读
/var/log/containers下的文件,统一送后端。运维简单,是默认选择。 - Sidecar:Pod 里加一个采集容器,适合日志写到文件、或需要单独过滤转发的场景。
8.3 阿里云 SLS + Logtail 的用法(控制台操作,未验证)
- 给集群启用 Logtail,确认
logtail-ds组件已安装。 - 登录 SLS 控制台,确认能看到 k8s 系统日志。
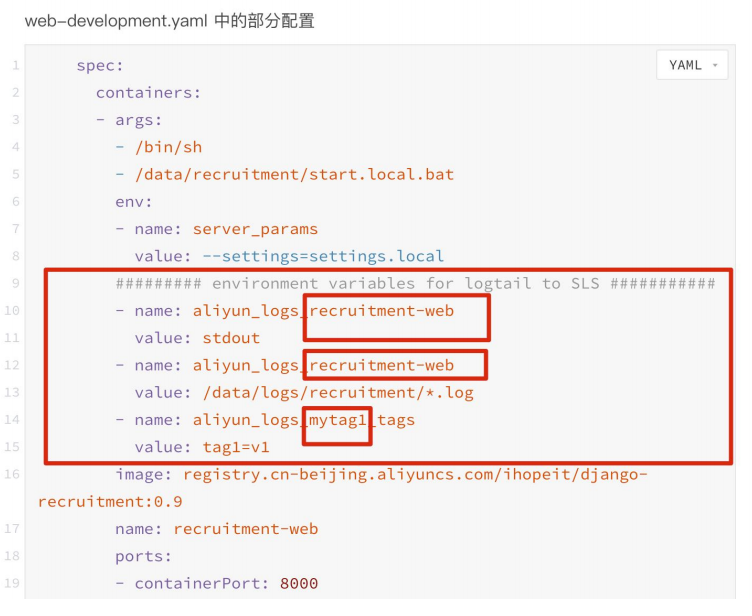
- 在 Deployment 里用环境变量声明采集配置,前缀固定是
aliyun_logs_:
1 | env: |
第一段表示「把容器标准输出采集到名为 recruitment-web 的 Logstore」,第二段是文件路径采集。走 stdout 那条更省事,也符合 8.1 的结论。
Django 侧要做的调整
1 | # 生产:日志写 stdout,交给采集端 |
如果坚持写文件,就把目录挂成 emptyDir 或持久卷,并保证路径与采集配置一致;容器可重建,本地路径不可依赖。
落地建议的顺序
- 先把非容器路线跑通:Gunicorn + systemd + Nginx(已实测,见《在宝塔上部署 Django 项目》)。这一步稳了再谈容器,否则你是在两个未知里找 bug。
- 写 Dockerfile,目标是「一条命令能起 web + redis + db」。
- 用 compose 把开发环境固化,CI 里跑同一份 compose(见《Django-云环境中的持续集成》)。
- 再考虑 k8s:先托管集群 + Deployment/Service/Ingress 三件套,探针和资源限额一次配好。
- 日志与监控同步跟上:stdout +
/metrics+ Sentry,三件都有之后再上生产。 - 数据库放云上托管实例,不要塞进容器编排。
参考
- Docker 官方:Get started 与 Docker Engine 文档:安装与基础命令。
- Docker 官方:Django 最佳实践:Dockerfile、卷与迁移的编排方式。
- Docker Compose 文档:
depends_on的condition、healthcheck、secrets(本机访问这几个页面拿不到响应,路径以官方站点当前结构为准)。 - Kubernetes 官方文档:StatefulSet、Service、Ingress、HPA 等概念页。
- kompose releases:compose 转 k8s 清单的工具。
- 阿里云:镜像加速服务、ACK Prometheus、Logtail 采集(控制台操作未在本机验证)。
- Django 官方:部署:与容器无关但必须先做对的那部分。